DeepSeek(深度求索)是杭州深度求索推出的大模型产品与开放平台:同一套能力可通过网页对话、官方 App、OpenAI / Anthropic 兼容 API,以及开源权重本地部署来使用。旗舰预览 DeepSeek-V4 强调推理与 Agent 能力,并已在网页端、App 与 API 上线;开发者可把模型接到 Claude Code、Cursor、自建脚本等编码工具里写代码、改仓库。本文按「它是什么 → 安装与开通 → 登录配置 → 日常对话与写代码 → 文档与跨场景辅助 → 本地部署与自动化 → 官方入口」展开,尽量写细,方便对照上手。
一、DeepSeek 是什么:先建立正确预期
可以把 DeepSeek 理解成「模型层 + 多个使用表面」,而不是单一 App。你买/用的是模型能力;入口可以是聊天窗口,也可以是编程智能体的后端。
1. 产品形态对照
| 入口 | 适合谁 | 典型用途 |
| --- | --- | --- |
| 网页对话 | 想零安装马上体验的人 | 问答、写作、读文件、开 DeepThink / 联网检索(以当前网页功能为准) |
| 官方 App(iOS / Android) | 移动端重度用户 | 通勤续聊、文件上传、跨端历史同步 |
| 开放平台 API | 开发者、团队自动化 | 接入业务系统、IDE / Agent、脚本与流水线 |
| 开源权重本地部署 | 要数据不出域、要私有化的人 | 用 vLLM / Ollama / 自建推理栈跑蒸馏版或全量模型 |
DeepSeek API 同时兼容 OpenAI 格式(https://api.deepseek.com)与 Anthropic 格式(https://api.deepseek.com/anthropic),因此大量现成 SDK、Cursor、Claude Code 等工具只需改 base URL 与密钥即可切换后端。
2. 当前常见模型怎么选(以官方文档为准)
| 模型 ID | 定位 | 建议场景 |
| --- | --- | --- |
| deepseek-v4-pro / deepseek-v4-pro[1m] | 旗舰、长上下文、更强 Agent | 复杂推理、多文件重构、长仓理解 |
| deepseek-v4-flash | 更快、更省 | 日常问答、子 Agent、高频小改动 |
| deepseek-chat / deepseek-reasoner | 旧别名 | 将于 2026/07/24 15:59 UTC 废弃;目前分别对应 flash 的非思考 / 思考模式,新项目请直接用 V4 名称 |
思考(thinking)可通过 API 参数开启,例如 thinking: {"type": "enabled"} 与 reasoning_effort(如 high)。网页 / App 里常见的 DeepThink 开关,本质上也是在「快速回答」与「更深推理」之间切换。
3. 它擅长什么
- 中英文对话、长文写作与改写
- 数学、逻辑与多步推理(开思考模式时更稳)
- 代码生成、解释、重构建议;经 Agent 工具可真正改仓库、跑命令
- 作为低成本、高兼容的「模型后端」接入现有开发工具链
- 开源权重支持研究、蒸馏与私有化部署
4. 它不替代什么
- 不替代你对业务事实、合规与上线风险的最终判断
- 网页/App 聊天不等于「已经替你改好了生产代码」——改仓库要走 IDE / CLI Agent 或你自己粘贴落地
- 云端 API 有数据出境与留存策略,敏感场景应评估自建或脱敏
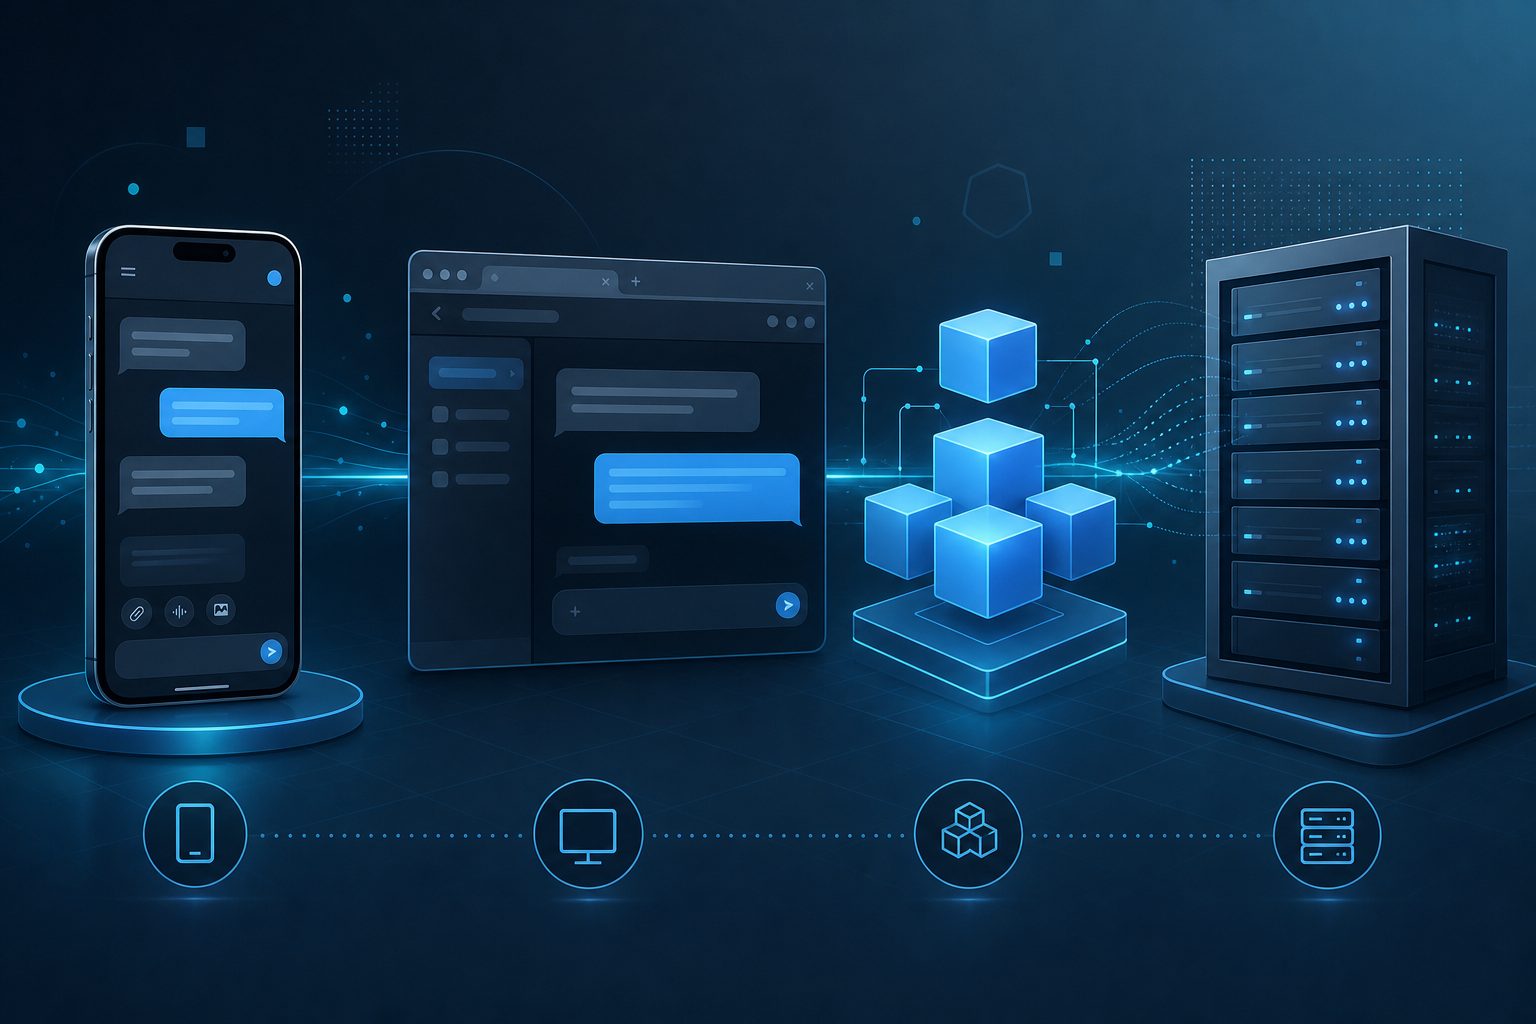
二、安装与开通:网页 / App / API / 本地四条路径
1. 网页端(最快)
- 打开官网 https://www.deepseek.com 或对话入口(常见为 chat.deepseek.com,以官网跳转为准)
- 注册 / 登录后即可开始对话
- 按需开启 DeepThink、联网搜索、上传文件等能力(界面开关以当前版本为准)
零安装,适合先验证模型风格与是否符合团队需求。
2. 官方手机 App
- iOS:App Store 搜索 DeepSeek,确认开发者为杭州深度求索相关主体后再安装
- Android:优先 Google Play 官方包;若所在地区无上架,仅从官网提供的下载页获取签名 APK,不要从不明第三方镜像站安装
安装后可用邮箱或常见第三方账号登录(以 App 当前支持项为准),开启跨端历史同步。注意商店里仿冒包不少,务必核对开发者名称。
3. 开放平台 API(写代码 / 接 Agent 必备)
- 打开 https://platform.deepseek.com 注册并完成实名等平台要求
- 在控制台创建 API Key,充值或确认额度
- 查阅价格页与服务状态,避免高峰期误判为「模型坏了」
核心配置:
| 参数 | 值 |
| --- | --- |
| OpenAI base_url | https://api.deepseek.com |
| Anthropic base_url | https://api.deepseek.com/anthropic |
| 鉴权 | Authorization: Bearer <API_KEY>(OpenAI 风格)或工具要求的 Auth Token |
| 推荐模型 | deepseek-v4-pro / deepseek-v4-flash |
4. 本地 / 私有化(可选)
开源权重可通过 Hugging Face、魔搭等渠道获取(具体许可与型号以仓库说明为准)。常见跑法:
- 消费级尝鲜:Ollama / LM Studio 等拉取蒸馏小模型
- 生产推理:vLLM、SGLang、TensorRT-LLM 等服务化部署
- 注意:全量旗舰参数量大,显存与带宽要求高;多数个人场景用蒸馏版或直接走云端 API 更现实
三、登录、密钥安全与第一次验证
1. 聊天账号 vs API Key
- 网页 / App 账号:管的是对话产品与历史
- API Key:管的是程序调用与按量计费
两者不要混用概念:App 能聊,不代表你的脚本已经配好了 Key。
2. 密钥安全清单
- Key 只放环境变量或密钥管理,不要写进 Git
- 泄漏后立刻在平台作废并轮换
- 给自动化单独开 Key,便于限额与审计
- 团队共享用平台子账号 / 权限,而不是互相转发同一把 Key
3. 第一次 API 验证(curl)
export DEEPSEEK_API_KEY=你的密钥

curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
        "model": "deepseek-v4-flash",
        "messages": [
          {"role": "system", "content": "You are a helpful assistant."},
          {"role": "user", "content": "用三句话介绍你自己"}
        ],
        "stream": false
      }'
需要更深推理时,可改为 deepseek-v4-pro,并加上:
"thinking": {"type": "enabled"},
"reasoning_effort": "high"
4. Python 最小示例(OpenAI SDK)
pip install openaiimport os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DEEPSEEK_API_KEY"],
base_url="https://api.deepseek.com",
)
resp = client.chat.completions.create(
model="deepseek-v4-pro",
messages=[
{"role": "system", "content": "你是严谨的编程助手,不确定就说明不确定。"},
{"role": "user", "content": "解释这段报错可能的原因,并给出排查步骤……"},
],
)
print(resp.choices[0].message.content)API 无状态:每次请求需自行带上完整 messages 历史;网页 / App 才会帮你保存会话。
四、日常使用:对话技巧与工作流
1. 网页 / App 里怎么问更有效
好提示通常包含:
- 角色与标准:你是谁、输出要多严谨
- 材料:粘贴原文、表格、报错、截图说明(或上传文件)
- 约束:字数、格式、禁止编造链接/数据
- 验收:需要清单、对比表、还是可直接粘贴的文稿
示例:
你是技术编辑。根据下面会议纪要整理成行动项表格:
列:事项 / 负责人 / 截止日期 / 风险。
不要发明纪要里没有的人;缺信息标「待确认」。
——原文——
……
2. 何时开 DeepThink / thinking
| 场景 | 建议 |
| --- | --- |
| 短问答、润色、翻译 | flash / 关闭强思考即可 |
| 数学证明、复杂排障、方案对比 | pro + thinking |
| 长仓库、跨很多文件的 Agent 任务 | pro[1m] + 较高 effort |
思考模式更慢、更贵,但在「一步错全盘错」的任务上往往更值。
3. 文件、检索与长上下文
- 上传 PDF / 代码 / 表格前,先说明你要它「抽取什么、输出什么」
- 开联网时,要求它标注来源,并对关键数字做交叉核对
- 超长材料优先「先列大纲再分段深挖」,避免一次塞爆有效注意力
五、代码编辑:从「给代码」到「改仓库」
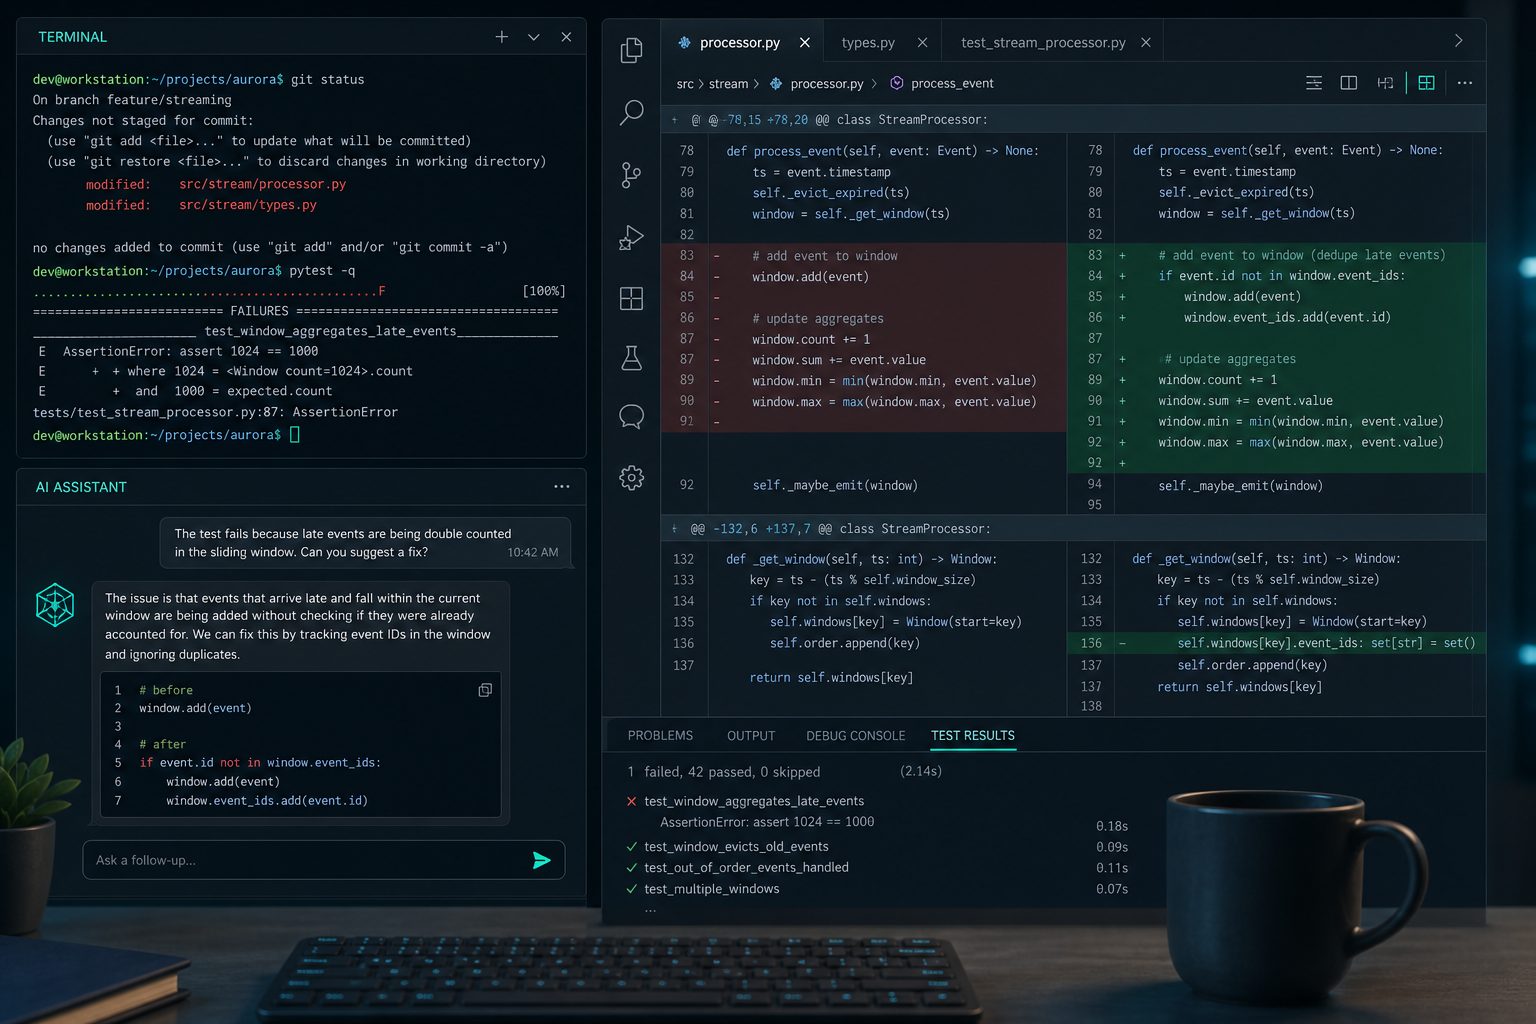
DeepSeek 本身是模型;真正改文件、跑测试通常要借助 Agent / IDE。下面按投入从低到高排列。
1. 纯对话写代码(网页 / App)
适合:算法题、小函数、看不懂的片段解释、设计草案。
语言:TypeScript + React。
约束:不要引入新依赖;保持现有 props 命名。
任务:给 SearchBox 增加防抖 300ms,并补一段 vitest。
输出:完整可粘贴代码 + 简短说明。
落地仍需你自己复制进仓库并跑测试。
2. 在 Cursor / VS Code 里把 DeepSeek 设为模型
许多编辑器支持「自定义 OpenAI 兼容端点」:
- Base URL:
https://api.deepseek.com(有的工具要写成带/v1的形式,以该工具文档为准) - API Key:你的 DeepSeek Key
- Model:
deepseek-v4-pro或deepseek-v4-flash
也有面向 Copilot Chat 的第三方 DeepSeek Provider 扩展(安装前核对发布者与权限)。配好后即可在侧栏 Agent / Chat 里让它直接改工作区文件。
3. 把 Claude Code 接到 DeepSeek(官方推荐路径)
若已安装 Claude Code CLI,可把 Anthropic 兼容端点指到 DeepSeek(密钥从开放平台获取):
macOS / Linux:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<你的 DeepSeek API Key>
export ANTHROPIC_MODEL=deepseek-v4-pro[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-v4-pro[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-v4-pro[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-v4-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-v4-flash
export CLAUDE_CODE_EFFORT_LEVEL=max
然后在项目目录执行 claude。主 Agent 用 pro、子任务用 flash,是常见的性价比组合。也可用项目 .claude/settings.json 的 env 字段固化配置,避免每次 export。
说明:Claude Desktop 的登录方式与 CLI 不同,不一定吃这套环境变量;写代码优先终端 / VS Code 扩展表面。
4. 代码任务分层
| 层级 | 例子 | 建议 |
| --- | --- | --- |
| 小 | 改函数、补日志 | 对话或 IDE Chat 直接做 |
| 中 | 跨 3–5 文件小功能 | Agent + 明确验收命令 |
| 大 | 模块迁移 | 先计划再执行;分段提交可回滚 |
5. 写代码时的审查清单
- 是否改到了范围外文件?
- 是否编造了不存在的 API / 配置项?
- 测试是否真的跑过?
- 有没有把密钥写进代码?
- 依赖版本是否被悄悄升级?
6. 用 API 做「半自动」小工具
例如:对 git diff 做中文审查摘要、对失败日志做归类。把 diff 读入后调用 chat completions,输出固定 JSON/Markdown 模板,再接到 CI 评论机器人——这是 DeepSeek 很常见的工程用法。
六、不止写代码:文档、知识与其他领域辅助
跨领域使用的原则同样是:给真实材料 + 固定产出格式 + 禁止编造。
1. 技术文档与 README
根据仓库真实目录与 package.json,重写 docs/getting-started.md:
分系统写安装步骤;只列出真实存在的脚本;不确定标 TODO。
2. 学习与答疑
适合:概念对比、错题讲解、论文精读提纲。要求它「先给结论再给推导」,并对可能过时的库版本标注「请以官方文档为准」。
3. 写作、翻译与润色
- 指定读者(高管 / 工程师 / 用户)与语气
- 提供术语表,避免同一概念多种译名
- 合同、医疗、法律等场景只能作草稿,必须人工复核
4. 数据分析辅助
- 写 pandas / SQL 草稿、解释指标口径
- 要求标注假设;不要让它假装已经跑过你没提供的数据结果
5. 办公与协作
- 会议纪要 → 行动项
- 竞品材料(你提供原文)→ 对比表
- 周报结构生成(你填事实)
6. 产品与方案
可用来写 PRD 骨架、用户故事、验收标准;拍板与优先级仍由人定。
七、本地部署、成本与自动化
1. 什么时候值得本地跑
- 代码 / 数据不能出内网
- 要稳定的单位成本与延迟
- 研究微调、蒸馏、评测
否则优先云端 API:运维更简单,也更容易跟上 V4 等新版本。
2. 成本意识
- flash 做高频;pro / thinking 做关键路径
- 利用缓存友好的稳定 system prompt 前缀(若平台提供缓存计价)
- Agent 工具调用会放大 token,设置好步数上限与目录白名单
具体单价以 API 价格页 开放平台说明为准,本文不写死数字以免过时。
3. 自动化例子
- CI 评论:PR 打开时用 flash 做风格/安全初检
- 夜间任务:拉取失败 Job 日志,生成归类报告发到群
- 文档同步:合并 main 后用脚本让模型根据 diff 起草 changelog,人工改完再发
自动化里永远保留「人审合并」门禁。
八、推荐学习路径(两周)
第 1–2 天:网页 / App 摸清风格
- 完成注册,试 DeepThink 开关差异
- 用同一道难题对比开关前后质量
第 3–5 天:打通 API
- 创建 Key,跑通 curl 与一段 Python
- 把 Key 放进环境变量,写一个读文件问答的小脚本
第 6–10 天:接到编辑器 / Claude Code
- 在 Cursor 或 Claude Code 配好 DeepSeek 后端
- 每天完成一个可提交的小改动,并审查 diff
第 11–14 天:流程化
- 固定团队提示词模板(文档、审查、发布说明)
- 试一条 CI 初检或本地 Ollama 蒸馏模型对照
九、常见问题
Q:DeepSeek 和 ChatGPT / Claude 怎么选?
A:看订阅、数据合规、工具链与性价比。DeepSeek 强在兼容接口、开源生态与成本;ChatGPT / Claude 强在各自产品闭环与部分企业治理能力。可组合:聊天用 A,Agent 后端用 DeepSeek。
Q:为什么 API 里「没记忆」?
A:Chat Completions 是无状态的,需自行维护 messages。要记忆就自己存会话,或继续用网页 / App。
Q:旧模型名还能用吗?
A:deepseek-chat / deepseek-reasoner 有兼容期,将于 2026-07-24 废弃。新集成请改用 deepseek-v4-flash / deepseek-v4-pro。
Q:能否完全离线?
A:可以走开源权重本地部署,但硬件门槛与运维成本要单独评估;手机 App / 网页默认都需要联网。
十、官方入口
- 官网:https://www.deepseek.com
- 开放平台:https://platform.deepseek.com
- API 文档:https://api-docs.deepseek.com
- Agent 集成(含 Claude Code):见 API 文档中的 Agent Integrations
- App 下载:以官网「DeepSeek App」入口为准,警惕仿冒包
十一、小结
- 先网页体验,再开 API;要改仓库就接到 Cursor / Claude Code 等 Agent。
- 新项目用 deepseek-v4-pro / flash;旧 chat/reasoner 别名尽快迁移。
- 写代码:对话出草案,Agent 落仓,每次看 diff 与测试。
- 写文档与其他辅助:给真实材料,禁止编造,格式写死。
- 敏感数据考虑本地部署;自动化只做初检,合并仍需人审。